Data Science2025
Time Series Forecasting — Battle Royale
Exploration et benchmark de modèles deep learning pour la prédiction de ventes : LSTM from scratch vs Nixtla NeuralForecast (MLP, NHITS).
PyTorchLSTMTime SeriesNeuralForecastKaggleDeep LearningPythonPandas
Contexte & Dataset
Projet d'exploration des architectures deep learning pour la prédiction de séries temporelles, basé sur le dataset Kaggle "Store Sales — Time Series Forecasting".
Dataset :
• 3 millions de lignes de données de ventes
• 4.6 années d'historique (janvier 2013 – août 2017)
• 54 magasins, 33 familles de produits
• Variables : date, store_nbr, family, sales, onpromotion
Focus du notebook :
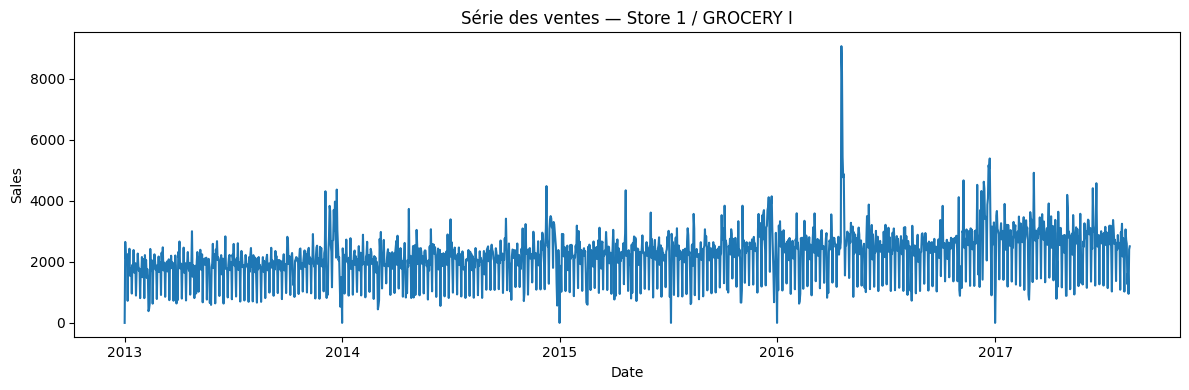
Pour ce benchmark, focus sur une seule série temporelle : Store 1, famille GROCERY I, soit 1 684 jours de données. L'objectif est de comparer les architectures sans le bruit de la multi-dimensionnalité.
Objectifs pédagogiques :
• Comprendre les fondamentaux des LSTM en implémentant from scratch
• Comparer avec des frameworks industriels (Nixtla NeuralForecast)
• Évaluer si la complexité architecturale se traduit en performance
3M
Lignes
4.6 ans
Période
54
Magasins
1 684 jours
Focus
1 / 2
Visualisation de la série temporelle : ventes journalières sur 4+ années
LSTM from Scratch (PyTorch)
Implémentation manuelle d'un LSTM en PyTorch pour comprendre les mécanismes internes du modèle.
Architecture implémentée :
• Input : séquence de 30 jours (lookback window)
• LSTM : 1 couche de 50 hidden units, suivie d'une couche linéaire
• Output : prédiction du jour suivant
• Loss : MSE (Mean Squared Error)
• Optimizer : Adam avec learning rate 0.001
Prétraitement :
• Normalisation Min-Max des ventes
• Création de séquences glissantes (sliding window)
• Test : les 14 derniers jours de la série (horizon de prédiction)
Intuition LSTM :
Le LSTM (Long Short-Term Memory) utilise des portes (forget, input, output) pour contrôler le flux d'information. Contrairement aux RNN classiques, il peut capturer des dépendances à long terme grâce à sa cellule mémoire.
Résultat : MAE 452.2, RMSE 593.9
L'implémentation manuelle sert de baseline pour évaluer les frameworks optimisés.
30 jours
Lookback
50 units
Hidden
452.2
MAE
593.9
RMSE
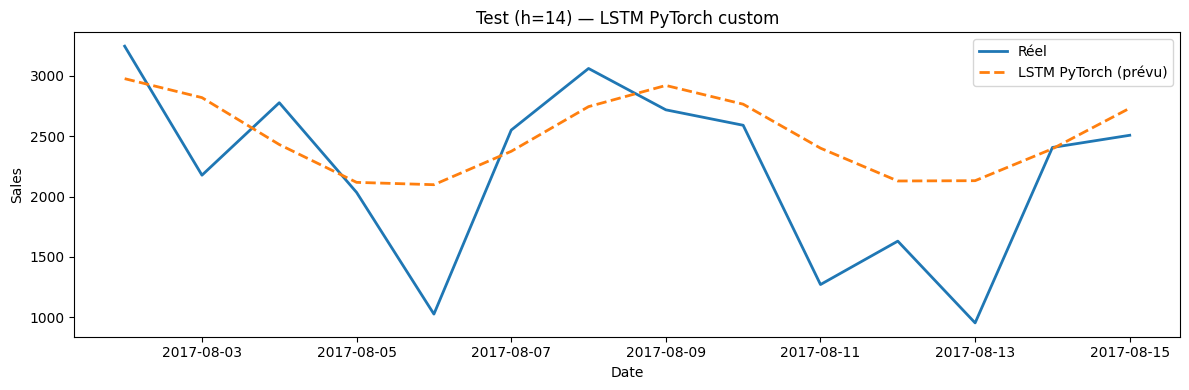
LSTM from scratch : prédictions vs réalité sur le set de test
Nixtla NeuralForecast
Comparaison avec trois modèles de la librairie NeuralForecast de Nixtla, framework industriel pour le forecasting.
Modèles évalués :
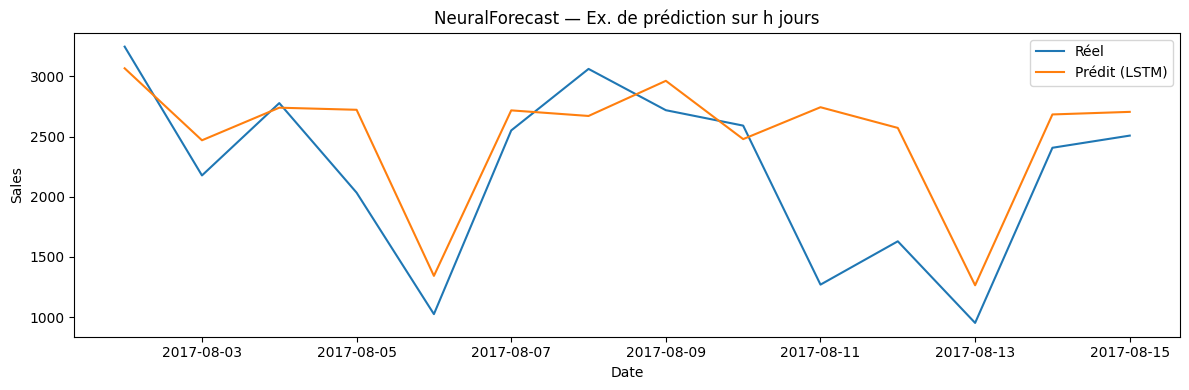
1. LSTM (Nixtla) — Implémentation NeuralForecast (encodeur LSTM + décodeur MLP), avec la même fenêtre de 30 jours. Résultat : MAE 402.3, RMSE 549.0
2. MLP (Multi-Layer Perceptron) — Architecture simple : couches denses sans mémoire temporelle. Le modèle apprend des patterns positionnels (jour de semaine, etc.) plutôt que séquentiels. Résultat : MAE 356.8, RMSE 504.7
3. NHITS (Neural Hierarchical Interpolation for Time Series) — Architecture état de l'art avec sampling multi-échelle et interpolation hiérarchique. Conçu pour capturer des patterns à différentes granularités. Résultat : MAE 404.8, RMSE 526.4
Observation clé :
Le MLP, malgré sa simplicité, bat les architectures sophistiquées. Cela suggère que les ventes suivent des patterns positionnels (jour de semaine, fin de mois) plus que des dépendances séquentielles.
MAE 402.3
LSTM Nixtla
MAE 356.8
MLP
MAE 404.8
NHITS
MLP
Best
1 / 2
LSTM Nixtla : meilleure calibration que l'implémentation custom
Battle Royale — Résultats
Comparaison finale des 4 modèles sur les métriques MAE et RMSE, mesurées sur les 14 derniers jours de la série.
Classement selon le RMSE (écart de MAE par rapport à la baseline entre parenthèses) :
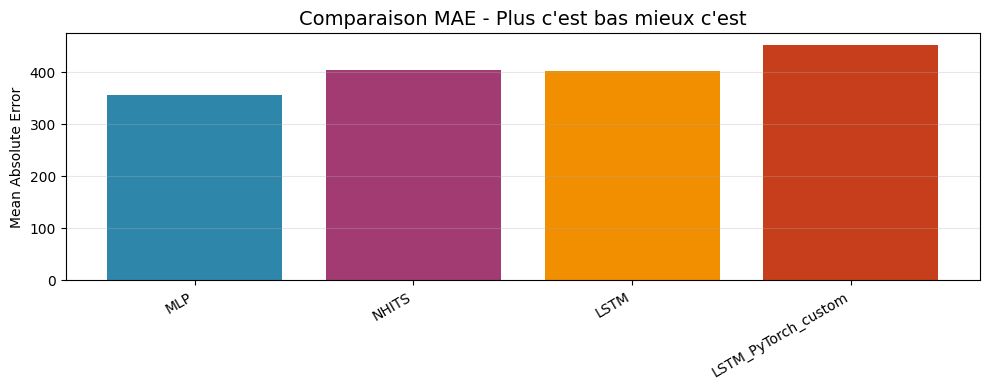
1er — MLP : MAE 356.8, RMSE 504.7 (MAE -21.1%)
2ème — NHITS : MAE 404.8, RMSE 526.4 (MAE -10.5%)
3ème — LSTM Nixtla : MAE 402.3, RMSE 549.0 (MAE -11.0%)
4ème — LSTM Custom : MAE 452.2, RMSE 593.9 (baseline)
Selon la MAE seule, LSTM Nixtla devance légèrement NHITS (402.3 contre 404.8).
Insights clés :
1. Complexité ≠ Performance — Le MLP (le plus simple) obtient une MAE inférieure de 11.9% à celle de NHITS (le plus sophistiqué), ainsi qu'un meilleur RMSE. La complexité architecturale n'est pas toujours payante.
2. Nature des patterns — Les ventes suivent des patterns positionnels (quel jour de la semaine) plutôt que séquentiels (qu'est-ce qui s'est passé hier). Le MLP capture mieux ces patterns.
3. Framework vs Custom — Les trois modèles NeuralForecast obtiennent une MAE et un RMSE inférieurs à ceux de l'implémentation manuelle.
Recommandation : Pour ce type de données retail, commencer par un MLP avant d'investir dans des architectures complexes.
MLP
Vainqueur
+21.1%
Gain MAE
Simple > Complex
Insight
Positionnel
Pattern
1 / 2
MAE par modèle : MLP (356.8) domine le classement